
Effectief samenwerken aan storingen begint met vier zaken die je vooraf regelt: snelle detectie, afgesproken triagecriteria, een duidelijke rolverdeling en een vast punt waar bevindingen terechtkomen. Zonder die basis werkt elke storing als een nieuwe puzzel die iedereen opnieuw moet ontcijferen. Met monitoring, heldere escalatiepaden en een centraal logboek zoals Carozo bouw je een team dat sneller schakelt en minder vaak dezelfde fout herhaalt.
Kort samengevat:
- Zonder vaste triagecriteria, rolverdeling en centraal logboek kost elke storing onnodig veel tijd en verhoogt het risico op herhaling van fouten.
- Het opstellen van duidelijke responstijden en het trainen van personeel in vastgestelde procedures minimaliseert tijdverlies en verhoogt de efficiëntie bij incidenten.
- Het vastleggen van specifieke meetwaarden, foutcodes en bevindingen op het moment zelf zorgt voor een doorzoekbare en waardevolle diagnosegeschiedenis.
- Het gebruik van een digitaal diagnostisch logboek en AI-ondersteuning versterkt kennisdeling en voorkomt dat waardevolle kennis verloren gaat bij vertrek of pensioen van ervaren monteurs.
- Een gestructureerde aanpak en regelmatige evaluatie na storingen verbeteren teamcohesie en voorkomen dat fouten zich herhalen, waardoor de kwaliteit van incidentmanagement verbetert.
Inhoudsopgave
- Kernprincipes van samenwerking bij storingen
- Rolverdeling en triage: wie besluit, wie voert uit
- Communicatie en overdracht tijdens en na de storing
- Documentatie en kennismanagement: hoe je diagnosekennis vasthoudt
- Beschikbaarheid, piketroosters en SLA's zonder overbelasting
- Wat teamcohesie en leren na incidenten echt opleveren
- Carozo maakt diagnosekennis van je team overdraagbaar
- Bronnen
- Veelgestelde vragen
Kernprincipes van samenwerking bij storingen
Een storing wordt pas een teamprobleem als iedereen dezelfde signalen ziet en dezelfde taal spreekt. Monitoring en alarmmanagement vormen de eerste laag: je wilt afwijkingen vroeg zien, maar niet verdrinken in meldingen die niets betekenen. Onderzoek naar alarmmanagement en HMI-ontwerp laat zien dat te veel irrelevante alarmen de belasting op operators verhoogt en de kans op fouten vergroot, dus filter bewust op relevantie voordat je een melding doorstuurt.
Daarna komt triage: niet elke storing verdient dezelfde snelheid van reageren. Werk met heldere beslisregels die iedereen kent en die je team snel kan toepassen.
- Veiligheidsrisico: direct escaleren, ongeacht het tijdstip.
- Productie-impact: vraagt snelle actie, maar via het normale escalatiepad.
- Informatief: loggen en meenemen in de volgende briefing.
Een simpele triagevraag als "kan dit voertuig of deze werkplek nu onveilig worden?" voorkomt dat elke melding als spoedgeval wordt behandeld, terwijl echte spoedgevallen wel meteen worden herkend.
Rolverdeling en triage: wie besluit, wie voert uit
Zonder vastgelegde rollen ontstaat er tijdens een storing discussie over wie de leiding heeft, en dat kost tijd die je niet hebt. Structureel incidentmanagement vraagt om vooraf gedefinieerde triagecriteria per discipline en een escalatiekader met afdwingbare responstijden, zo blijkt uit aanbevelingen voor gestructureerd incidentmanagement. Vergelijkbaar met de manier waarop netbeheerders 24/7 aanspreekbare rollen inrichten voor kritieke systemen, werkt dat ook in een werkplaats.
- Wijs een verantwoordelijke aan die 24/7 bereikbaar is voor veiligheidskritieke storingen, ook buiten diensttijd.
- Bepaal een escalatieladder met vaste responstijden: veiligheidskritieke gevallen krijgen reactie binnen enkele minuten, productieverstoringen binnen het uur, informatieve meldingen bij de volgende briefing.
- Zet rollen en telefoonnummers in één overzicht, bijvoorbeeld op een gedeeld bord of in een digitaal systeem, zodat niemand tijdens een storing hoeft te zoeken.
Deze structuur werkt alleen als iedereen het overzicht kent voordat de storing zich voordoet. Oefen het scenario dus regelmatig, niet pas wanneer de druk al hoog is.
Communicatie en overdracht tijdens en na de storing
De meeste kennis die tijdens een storing verloren gaat, verdwijnt niet door onwil maar door haast. Iemand belt een collega, legt iets mondeling uit, en de volgende ploeg begint weer bij nul. Een tijdgestempeld logboek voorkomt dat: wat is fout, wat is al getest, welke meetwaarden kwamen daaruit, en wat is de volgende stap.
Werk met een vast handoverformat, zodat elke overdracht dezelfde structuur volgt en reproduceerbaar is, ook als de persoon die overdraagt er zelf niet bij kan blijven.
- Voertuig en foutcode: wat is het probleem en waar is het vastgesteld.
- Getest en uitgesloten: welke oorzaken zijn al gecontroleerd.
- Meetwaarden: concrete cijfers, niet alleen een indruk.
- Volgende stap: wat de volgende monteur als eerste moet doen.
Ad-hoc communicatie, zoals een snelle app-bericht om iets tijdelijk te omzeilen, mag bestaan, maar maak die stap zichtbaar en tijdelijk. Noteer wat er is overgeslagen en waarom, zodat niemand later denkt dat de officiële procedure is gevolgd.
Pro-tip: zet vaste velden in je logboek verplicht, zo vergeet niemand een meetwaarde te noteren, ook niet onder tijdsdruk.
Documentatie en kennismanagement: hoe je diagnosekennis vasthoudt
Een groot deel van de meest waardevolle diagnostische kennis in een werkplaats zit in de hoofden van ervaren monteurs en verdwijnt zodra zij vertrekken of met pensioen gaan. Dat risico verklein je alleen als vastleggen laagdrempelig is: een foto van een meetwaarde, een korte notitie, geen uitgebreid rapport dat niemand tijdens een drukke dag wil invullen.
- Registreer op het moment zelf: foutcodes, foto's en meetwaarden direct bij de diagnose, niet achteraf uit het geheugen.
- Koppel bevindingen aan het voertuig, zodat een volgende storing aan dezelfde auto direct de geschiedenis toont.
- Gebruik AI-ondersteuning die meedenkt op basis van eerder vastgelegde diagnoses, in plaats van elke keer opnieuw te zoeken.
Onderzoek naar kennismanagement met Graph RAG laat zien dat deze aanpak de diagnostische duidelijkheid en kennisoverdracht tussen ervaren en jonge technici kan verbeteren vergeleken met klassieke systemen zonder gestructureerde kennisbank, volgens experimentele studies (Knowledge Management for Automobile Failure).
Junior monteurs profiteren het meest van doorzoekbare kennis, omdat zij minder ervaring hebben om op terug te vallen en dus vaker leunen op wat een collega ooit al heeft uitgevogeld.
De workflow werkt in drie stappen: een incident wordt vastgelegd, het team bekijkt de casus terug tijdens een korte review, en waar nodig wordt de procedure zelf aangepast. Dat laatste noemt men double-loop learning: niet alleen de storing oplossen, maar ook het proces dat ertoe leidde bijstellen.
Beschikbaarheid, piketroosters en SLA's zonder overbelasting
Storingen houden zich niet aan kantoortijden, dus moet je keuzes maken over wie bereikbaar is en hoe. Een intern piket geeft controle en directe kennis van de installaties, maar belast je eigen team. Een externe storingsdienst ontlast monteurs, maar vraagt om een goed belscript en heldere overdracht van technische context.
| Aspect | Intern piket | Externe storingsdienst |
|---|---|---|
| Bereikbaarheid | Eigen team, korte lijnen | Uitbesteed, vraagt goede overdracht |
| Belasting monteurs | Hoger risico op overbelasting | Lager, maar minder directe kennis |
| Benodigd hulpmiddel | Real-time rooster, escalatielijst | Belscript en vastgelegde procedures |
| Geschikt bij | Kleine, hechte teams | Grotere spreiding of krappe bezetting |
Praktijkartikelen over storingsdiensten benadrukken dat een belscript en real-time roostertools cruciaal zijn om bereikbaarheid te organiseren zonder dat monteurs overbelast raken, en dat triage per discipline gespecificeerd moet zijn, omdat één generiek urgentieniveau zelden volstaat voor multidisciplinaire teams, zoals te lezen is in een relevant overzicht (overzicht over storingsdiensten). Leg responstijden vast en rapporteer erover, zodat je kunt aantonen dat de afspraken ook echt gehaald worden.
Wat teamcohesie en leren na incidenten echt opleveren

De teams die het snelst beter worden, zijn niet de teams met de meeste kennis, maar de teams die na elke storing dezelfde vraag stellen: wat leren we hiervan voor volgende keer. Double-loop learning werkt alleen als je het als vaste gewoonte inbouwt, niet als iets dat je doet wanneer er tijd over is.
Eén casus per kwartaal grondig nabespreken en vastleggen, inclusief wat er is aangepast in de procedure, doet meer voor de teamprestatie dan tien losse tips over communicatie.
— Jeroen
Carozo maakt diagnosekennis van je team overdraagbaar
De stap die de meeste werkplaatsen missen, is niet de wil om samen te werken, maar een plek waar diagnosekennis blijft staan zodra de storing is opgelost. Carozo is een digitaal diagnoselogboek waarin je per voertuig foutcodes, meetwaarden, foto's, documenten en bevindingen vastlegt, zodat het volledige diagnoseproces bewaard blijft.
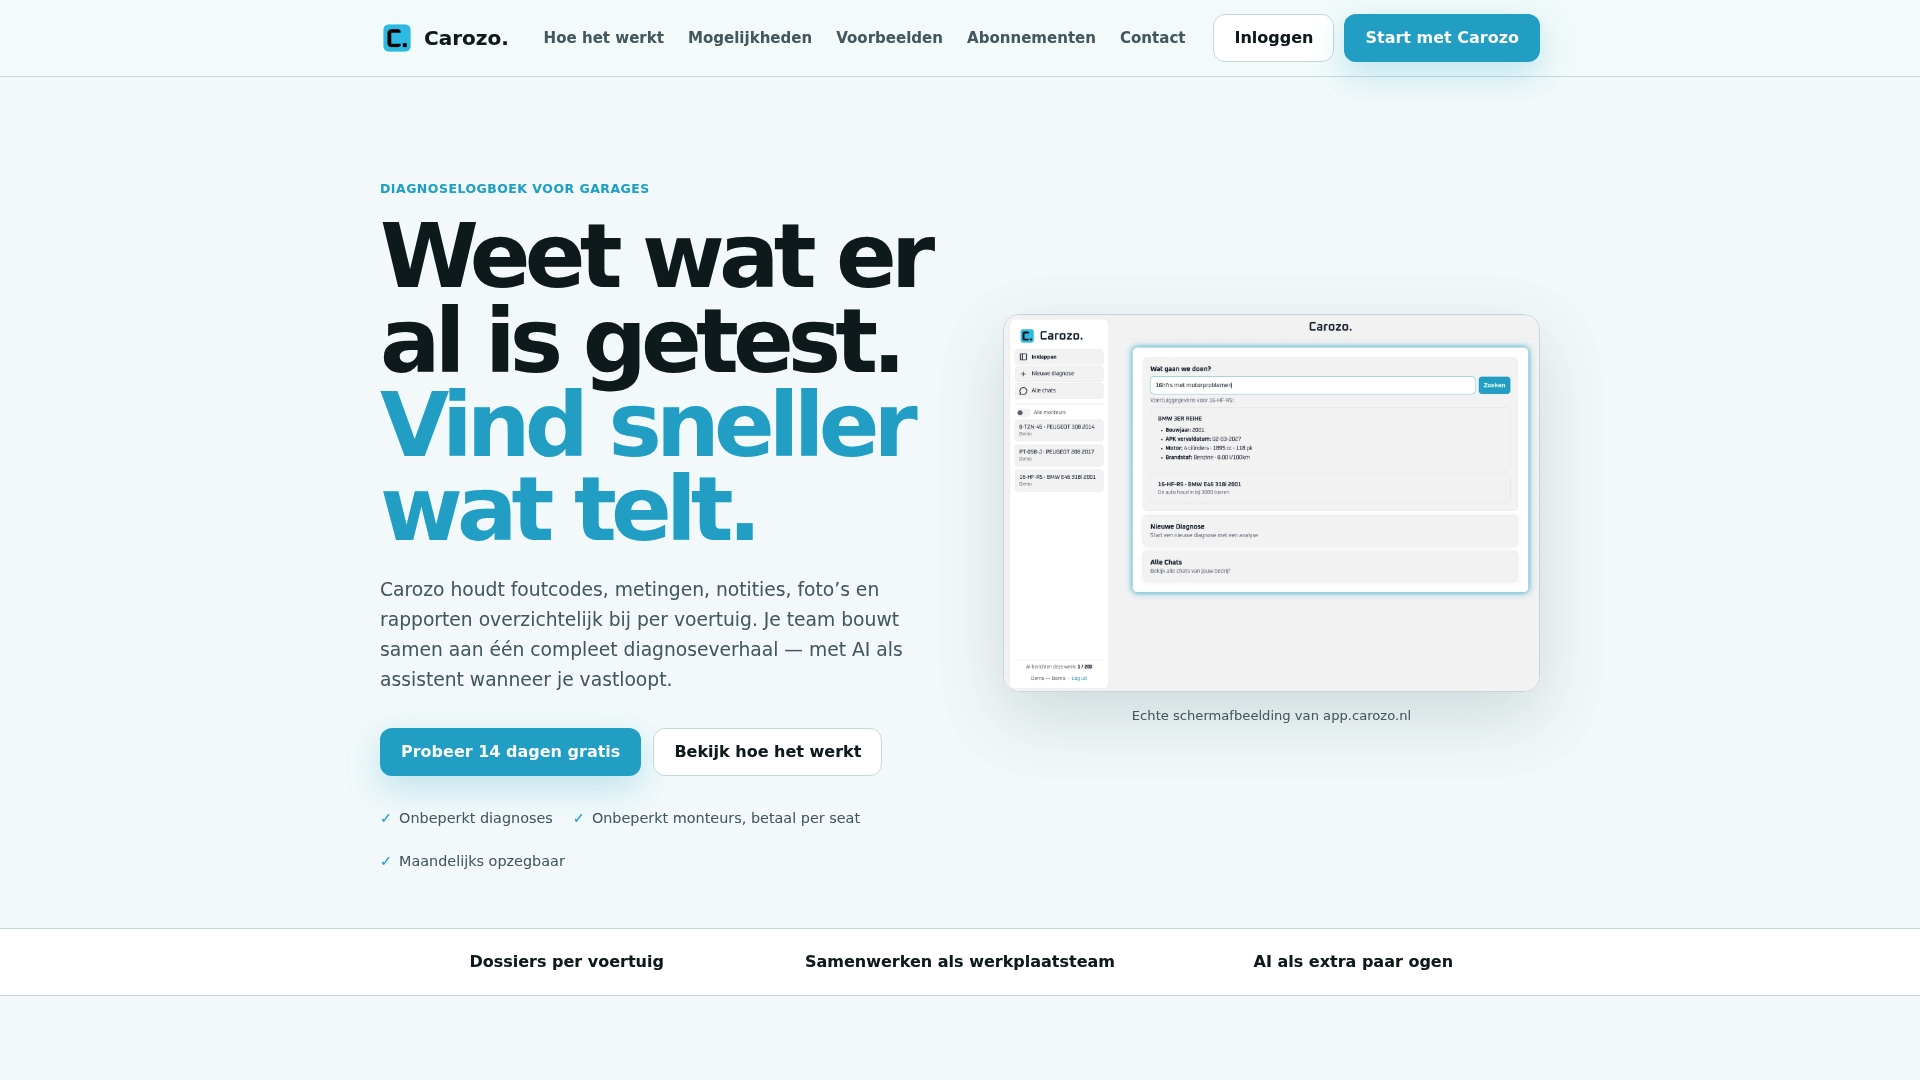
Een collega die een eerdere storing aan dezelfde auto behandelde, hoeft niet meer gebeld te worden: de diagnose staat al klaar, inclusief de redeneerstappen die ernaartoe leidden. De AI-assistent van Carozo kan op basis van de vastgelegde informatie meehelpen, waardoor monteurs minder vaak vanaf nul hoeven te beginnen en opgebouwde kennis binnen het bedrijf toegankelijk blijft. Bekijk de abonnementen van Carozo om te zien welk pakket past bij de grootte van je team.
Bronnen
Deze inzichten komen uit onderzoek naar menselijke factoren bij onderhoudsstoringen, richtlijnen voor incidentmanagement en triage en onderzoek naar Graph RAG voor kennismanagement.
- Structured incident management and triage recommendations
- Knowledge Management for Automobile Failure (Graph RAG)
Veelgestelde vragen
Wat is de eerste stap om beter samen te werken bij storingen?
Begin met heldere triagecriteria en een vaste rolverdeling, zodat iedereen weet wie beslist bij welk urgentieniveau. Zonder die basis kost elke storing extra tijd aan overleg voordat het echte werk begint.
Hoe voorkom je dat kennis verloren gaat na een storing?
Leg bevindingen vast op het moment zelf, met foto's, meetwaarden en korte notities in plaats van een uitgebreid rapport achteraf. Een digitaal diagnoselogboek zoals Carozo houdt die informatie doorzoekbaar voor het hele team.
Wat is double-loop learning en waarom is het nuttig bij storingen?
Double-loop learning betekent dat je niet alleen de storing oplost, maar ook de procedure aanpast die tot de storing leidde. Dat voorkomt dat dezelfde fout later opnieuw optreedt.
Moet je kiezen voor een intern piket of een externe storingsdienst?
Dat hangt af van de grootte van je team en het risico op overbelasting: een intern piket geeft directe kennis, een externe storingsdienst ontlast monteurs maar vraagt een goed belscript. Beide opties hebben heldere responstijden nodig om aantoonbaar te werken.
Wat kost Carozo als diagnoselogboek voor mijn werkplaats?
Carozo biedt verschillende abonnementen met verschillende niveaus van AI-ondersteuning; actuele prijsinformatie vindt u op de pricingpagina van Carozo. De actuele details staan op de pricingpagina van Carozo.